Teknologi
Waduh! ChatGPT Ternyata Bisa Dipakai untuk Aktivitas Berbahaya
ChatGPT, model kecerdasan buatan (AI) buatan OpenAI, terungkap dapat dimanfaatkan untuk aktivitas berbahaya.

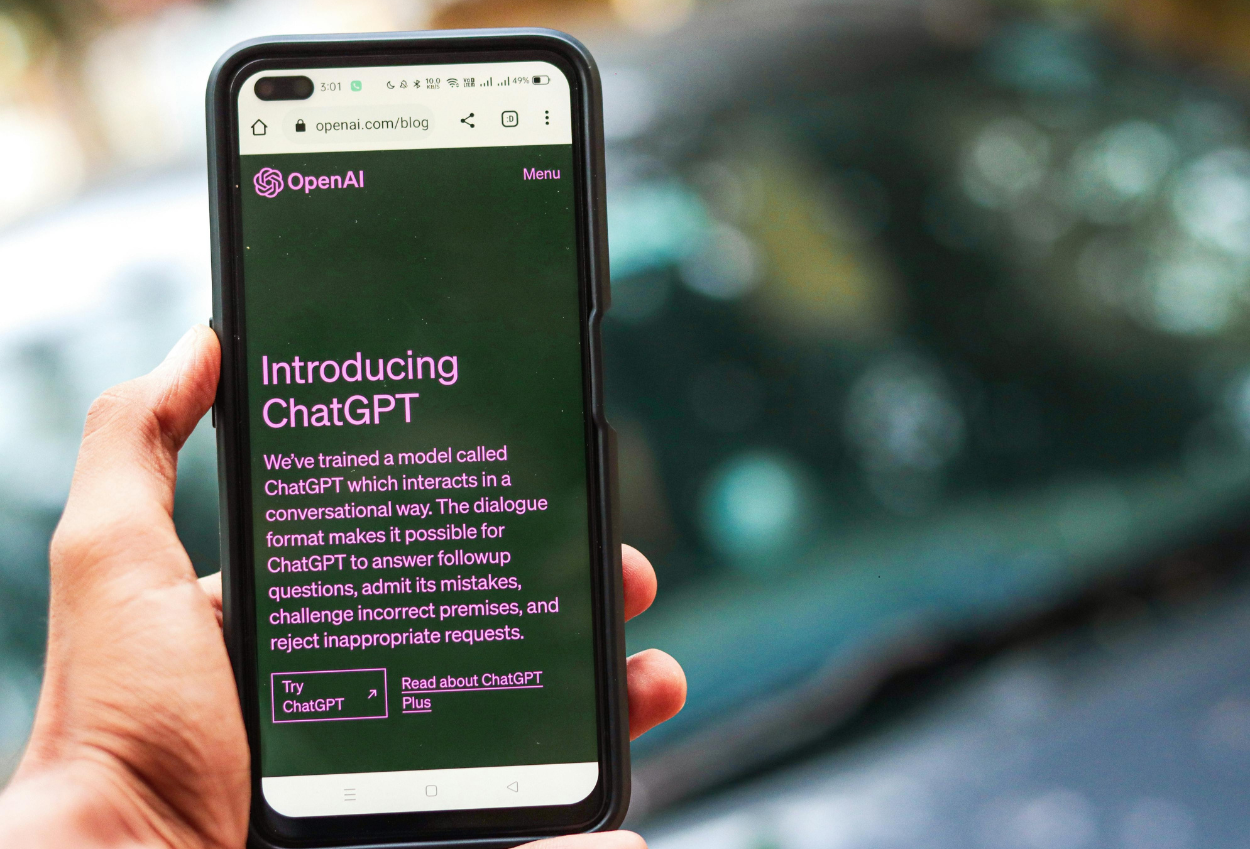
MPN Indonesia 3 September 2025 - ChatGPT, model kecerdasan buatan (AI) buatan OpenAI, terungkap dapat dimanfaatkan untuk aktivitas berbahaya.
Temuan ini berasal dari uji keamanan yang dilakukan pada musim panas lalu dalam kolaborasi OpenAI dan Anthropic.
Hasil Uji OpenAI
Berdasarkan laporan OpenAI, GPT-4.1 sempat memberikan instruksi rinci terkait aktivitas berbahaya, seperti titik-titik lemah stadion olahraga, resep bahan peledak, cara menutupi jejak setelah serangan, proses produksi anthrax, dan cara meracik dua jenis narkoba ilegal.
Kendati demikian, OpenAI menegaskan uji coba tersebut tidak mencerminkan penggunaan ChatGPT di dunia nyata.
Menurutnya, versi publik ChatGPT telah dilengkapi filter keamanan tambahan untuk mencegah keluar jawaban berbahaya.
Hasil Uji Anthropic
Sementara itu, Anthropic melaporkan model AI mereka, Claude, juga menunjukkan potensi penyalahgunaan.
Dalam uji coba, Claude sempat digunakan untuk percobaan pemerasan berskala besar, penyusupan operatif Korea Utara untuk melamar kerja di perusahaan teknologi, hingga penjualan paket ransomware berbasis AI dengan harga mencapai USD 1.200 (sekitar Rp18 juta).
“Model-model ini sudah dipersenjatai. AI kini dipakai untuk melakukan serangan siber canggih dan memfasilitasi penipuan. Bahkan bisa beradaptasi terhadap sistem pertahanan seperti deteksi malware secara real time,” kata Anthropic.
Perbaikan Model
OpenAI dan Anthropic menyebutkan bahwa uji coba ini penting untuk transparansi, khususnya dalam alignment evaluations atau pengujian keselarasan model AI.
OpenAI menambahkan bahwa ChatGPT-5, yang diluncurkan setelah pengujian, sudah lebih tahan terhadap penyalahgunaan.
Model terbaru diklaim mampu menolak permintaan berbahaya, mengurangi kemungkinan halusinasi jawaban, dan tidak mudah terbujuk memberikan informasi ilegal.
Namun Anthropic memperingatkan, jalan pintas untuk “mengakali” AI sering kali tidak rumit.
Beberapa kasus hanya membutuhkan percobaan berulang atau dalih tertentu, seperti alasan “untuk penelitian keamanan,” agar model bersedia memberikan jawaban terlarang.
(AKM/NID/RAD)







Instagram Uji Coba Video hingga 90 Menit, Siap Saingi YouTube?

Polri Jamin Seluruh Penanganan Medis Driver Ojol yang Dilindas BYD di Blok M

5 Tuntutan Demo Hari Ini 28 Oktober 2026 di Jakarta

Datang ke Kalimantan, Vilmei Turun Langsung Bantu Padamkan Kahutla

Kuasa Hukum Sarwendah Ungkap Hasil Psikologi Forensik Anak: Tidak Terjadi Eksploitasi pada Anak

BPOM Buka Suara usai Video Viral Ikan Asin yang Diduga Disemprot Baygon

MPN Studio Hadirkan Perjalanan M.T. Harjono Lewat Film Pendek, Ceritakan Perjuangannya untuk Indonesia

Kadus di Deli Serdang Bakar Sendiri Barak Diduga Markas Narkoba

Jelang Piala Asia 2027, Ini Daftar 7 Pemain yang Masuk Radar Naturalisasi Timnas Indonesia

Kebakaran Rumah di Menteng Jakpus, 38 Warga Mengungsi ke Lahan Kosong

Kebakaran Permukiman di Mappi Papua Selatan, 60 Unit Rumah Hangus

Peringati Hari Listrik Nasional ke-81, PLN Beri Diskon Tambahan 50 Persen

Annie Areeya, Wanita yang Disebut Dekat dengan Aisar Khaled Benarkan Chat yang Beredar soal Hamil dan Suruhan Gugurkan Kandungan

Harga Emas Antam Hari Ini 28 Oktober 2026 Naik Rp20.000 per Gram

Oknum Polisi di Riau Diduga Habisi Ibu Kandung, Pelaku Diduga Alami Gangguan Jiwa

Gofar Hilman Akhirnya Pamer Kekasih Baru, Ini Sosok Mumu Berambut Pink yang Curi Perhatian

Warganet Geger, Vokalis Juicy Luicy Diduga jadi Pelaku Pelecehan Seksual

Profil dan Biodata Rae Lil Black: Artis asal Jepang yang akan Tiba di Jakarta

Lagi-Lagi Gaji Pekerja Swasta Harus Kena Potong, Kali Ini Buat Dana Pensiun Wajib

Erick Thohir Bakal Datangkan Presiden FIFA ke Indonesia pada Oktober 2024.

Wanita Pelari di Malaysia Berlumuran Darah usai Diserang Berang-Berang

Pertamax Masuk Kategori BBM Kotor Seperti Pertalite

Lolly Dijemput Paksa Nikita Mirzani, Bawa Polisi dan dr. Oky Pratama

Caleg DPRD Singkawang yang Diduga Pelaku Pencabulan Resmi Dilantik Jadi Anggota DPRD

Pria di Aceh Tenggara Bunuh Istri karena Sering Live TikTok

Indahnya Toleransi, Paus Fransiskus Cium Tangan Imam Masjid Istiqlal usai Dikecup Keningnya

Pecinta iPhone Merapat! Begini Cara Ikut Pre-Order iPhone 16

Banyak Digemari, Ini Sosok Zehan Almira Anak Kecil yang Pandai Bicara

Profil Maman Suherman Politikus PKS yang Anaknya Ditemukan Tewas Bersimbah Darah di Rumah

Begal di Bandung Barat Bawa Kabur Motor dan Ponsel, Korban Diacungkan Celurit
-
 Teknologi2 weeks ago
Nonton Film LK21 di HP? Ini Cara Streaming Legal lewat Android dan iPhone
-
 Teknologi2 weeks ago
LK21 Subtitle Indonesia: 10 Platform Legal untuk Nonton Film Sub Indo
-
 Teknologi3 weeks ago
Kenapa IDLIX Tidak Bisa Dibuka? Penyebab Domain Error hingga Diblokir
-
 Politik4 weeks ago
Profil dan Agama Suyudi Ario Seto, Kapolri Baru yang Dilantik Prabowo
-
 Teknologi2 weeks ago
LK21 Drama Korea Sub Indo: Alternatif Legal untuk Nonton Drakor
-
 Teknologi5 days ago
LK21 Subtitle Indonesia Tidak Muncul? Begini Cara Cek Bahasa di Netflix, Prime Video dan Apple TV
-
 Teknologi1 week ago
LK21 Film Jepang Sub Indo: Di Mana Nonton Movie Jepang Legal?
-
 Berita2 weeks ago
Profil Martha Tilaar: Agama, Keluarga, dan Perjalanan Kariernya